15 分钟理解 vLLM:推理加速、分页注意力与 API 部署
程序猿DD2026.08.0915 分钟5,127 播放1 弹幕
编辑手记 · 大模型读完弹幕后的判断
有完整实验链路和原理推导,收藏比高,看完能复现vLLM部署
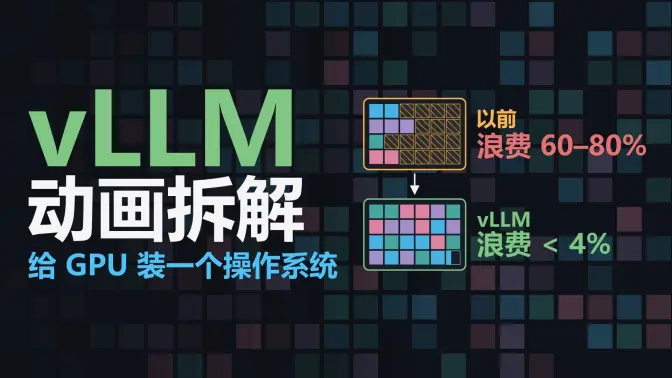
从HF单请求推理切入,讲KV Cache瓶颈、PagedAttention原理并部署OpenAI兼容API
- 适合谁
- LLM应用开发者与后端工程师
- 前置
- Python、Transformer基础、GPU环境
- 难度
- 中等 · ●●●○○
- 时效
- 有时效 · 部分工具已变
- 类型
- 教程