怎么加快大模型推理?10分钟学懂VLLM内部原理,KV Cache,PageAttention
RethinkFun2024.07.1512 分钟14.6 万 播放224 弹幕
编辑手记 · 大模型读完弹幕后的判断
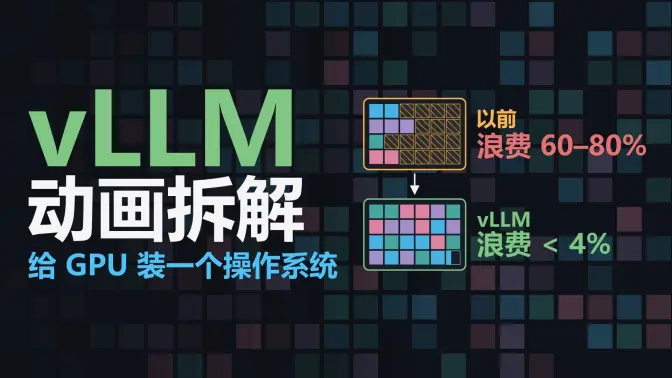
体系清晰、类比到位,把PagedAttention的虚拟/物理块映射讲明白了,适合入门建立直觉
10分钟讲清vLLM的KV Cache与PageAttention原理,用操作系统分页类比讲透显存管理
- 适合谁
- 想了解大模型推理优化的开发者
- 前置
- Transformer注意力机制基础
- 难度
- 中等 · ●●●○○
- 时效
- 有时效 · 部分工具已变
- 类型
- 教程