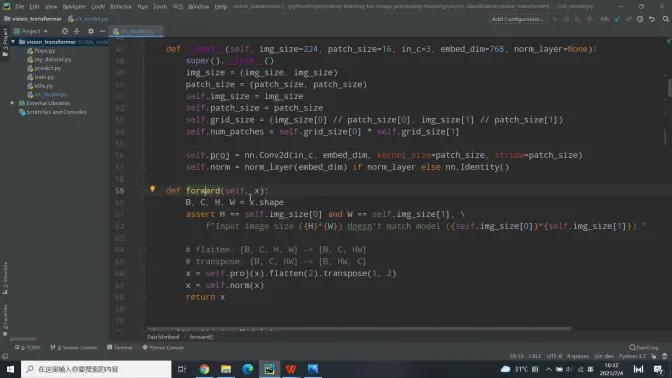
11.1 Vision Transformer(vit)网络详解
霹雳吧啦Wz2021.06.2725 分钟29.3 万 播放812 弹幕
编辑手记 · 大模型读完弹幕后的判断
结构讲解系统、推导清晰,弹幕讨论显示细节到位,适合入门ViT
逐层拆解ViT结构:patch嵌入、位置编码、编码器与分类头
- 适合谁
- 深度学习入门与CV方向学习者
- 前置
- CNN基础、Transformer注意力机制
- 难度
- 中等 · ●●●○○
- 时效
- 有时效 · 部分工具已变
- 类型
- 教程
编辑手记 · 大模型读完弹幕后的判断
结构讲解系统、推导清晰,弹幕讨论显示细节到位,适合入门ViT
逐层拆解ViT结构:patch嵌入、位置编码、编码器与分类头
关于这份清单
从 3,652 条候选中,经过相关性与质量规则筛选。
结合互动信号、简介与弹幕,生成内容判断和观看理由。
了解适合人群与前置知识,再决定从哪一课开始。